# 437. 路径总和 III
# 题目描述
给定一个二叉树的根节点 root ,和一个整数 targetSum ,求该二叉树里节点值之和等于 targetSum 的 路径 的数目。
路径 不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
示例 1:
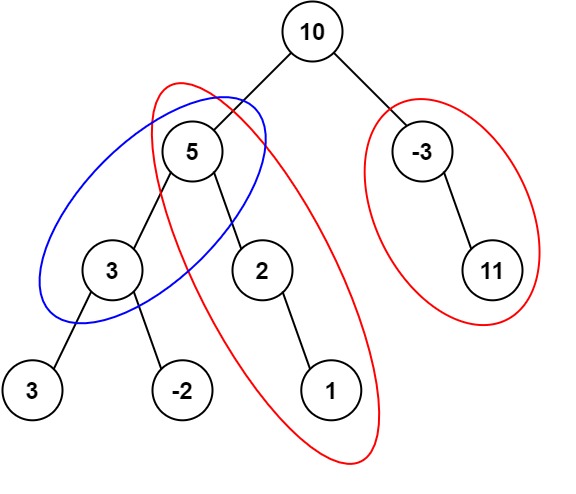
输入:root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8
输出:3
解释:和等于 8 的路径有 3 条,如图所示。
2
3
示例 2:
输入:root = [5,4,8,11,null,13,4,7,2,null,null,5,1], targetSum = 22
输出:3
2
提示:
- 二叉树的节点个数的范围是
[0, 1000] -10^9 <= Node.val <= 10^9-1000 <= targetSum <= 1000
# 思路
这道题和普通的路径和问题不一样,路径可以从任意节点开始,到任意节点结束,只要是向下的就行。
# 方法一:暴力DFS(双重递归)
最直接的想法:
- 外层递归遍历每个节点,把每个节点都当作起点
- 内层递归从该起点往下找,统计有多少条路径和为 targetSum
int pathSum(TreeNode* root, int targetSum) {
    if (root == nullptr) return 0;
    // 以当前节点为起点的路径数 + 左子树的路径数 + 右子树的路径数
    return rootSum(root, targetSum) + pathSum(root->left, targetSum) + pathSum(root->right, targetSum);
}

// 以root为起点,往下找路径和为targetSum的路径数
int rootSum(TreeNode* root, long long targetSum) {
    if (root == nullptr) return 0;
    int count = 0;
    if (root->val == targetSum) count++;
    count += rootSum(root->left, targetSum - root->val);
    count += rootSum(root->right, targetSum - root->val);
    return count;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
这种方法时间复杂度是 O(n²),每个节点都要往下遍历一次。
能不能优化到 O(n)?
# 方法二:前缀和 + 哈希表
回想一下数组中的"和为 K 的子数组"问题 560.和为 K 的子数组,用的就是前缀和 + 哈希表。
二叉树的路径,其实就是从根到当前节点的"前缀和"。
定义 prefixSum 为从根节点到当前节点的路径和。
如果要找以当前节点为终点、和为 targetSum 的路径,只需要找"之前有多少个节点的 prefixSum 等于 (当前prefixSum - targetSum)"。
为什么?
假设从节点 A 到当前节点 cur 的路径和为 targetSum:
- 根到 A 的路径和:prefixSum[A]
- 根到 cur 的路径和:prefixSum[cur]
- 那么 A 到 cur 的路径和 = prefixSum[cur] - prefixSum[A] = targetSum
- 所以 prefixSum[A] = prefixSum[cur] - targetSum
用哈希表记录每个前缀和出现的次数。
遍历过程:
- 更新当前的 prefixSum
- 查哈希表,看 (prefixSum - targetSum) 出现过几次,累加到结果
- 将当前 prefixSum 加入哈希表
- 递归左右子树
- 回溯:从哈希表中移除当前 prefixSum(因为只能往下走,不能走兄弟路径)
这一点很重要:
为什么要回溯?因为当前节点的左子树路径不能和右子树路径共享前缀。
举个例子:
    1
   / \
  2   3
2
3
遍历左子树 2 的时候,把 prefixSum[2] 加入哈希表。遍历完左子树后,要把 prefixSum[2] 移除,不然遍历右子树 3 的时候会误以为可以"从 2 到 3"。
# 模拟过程
以示例 1 为例:root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8
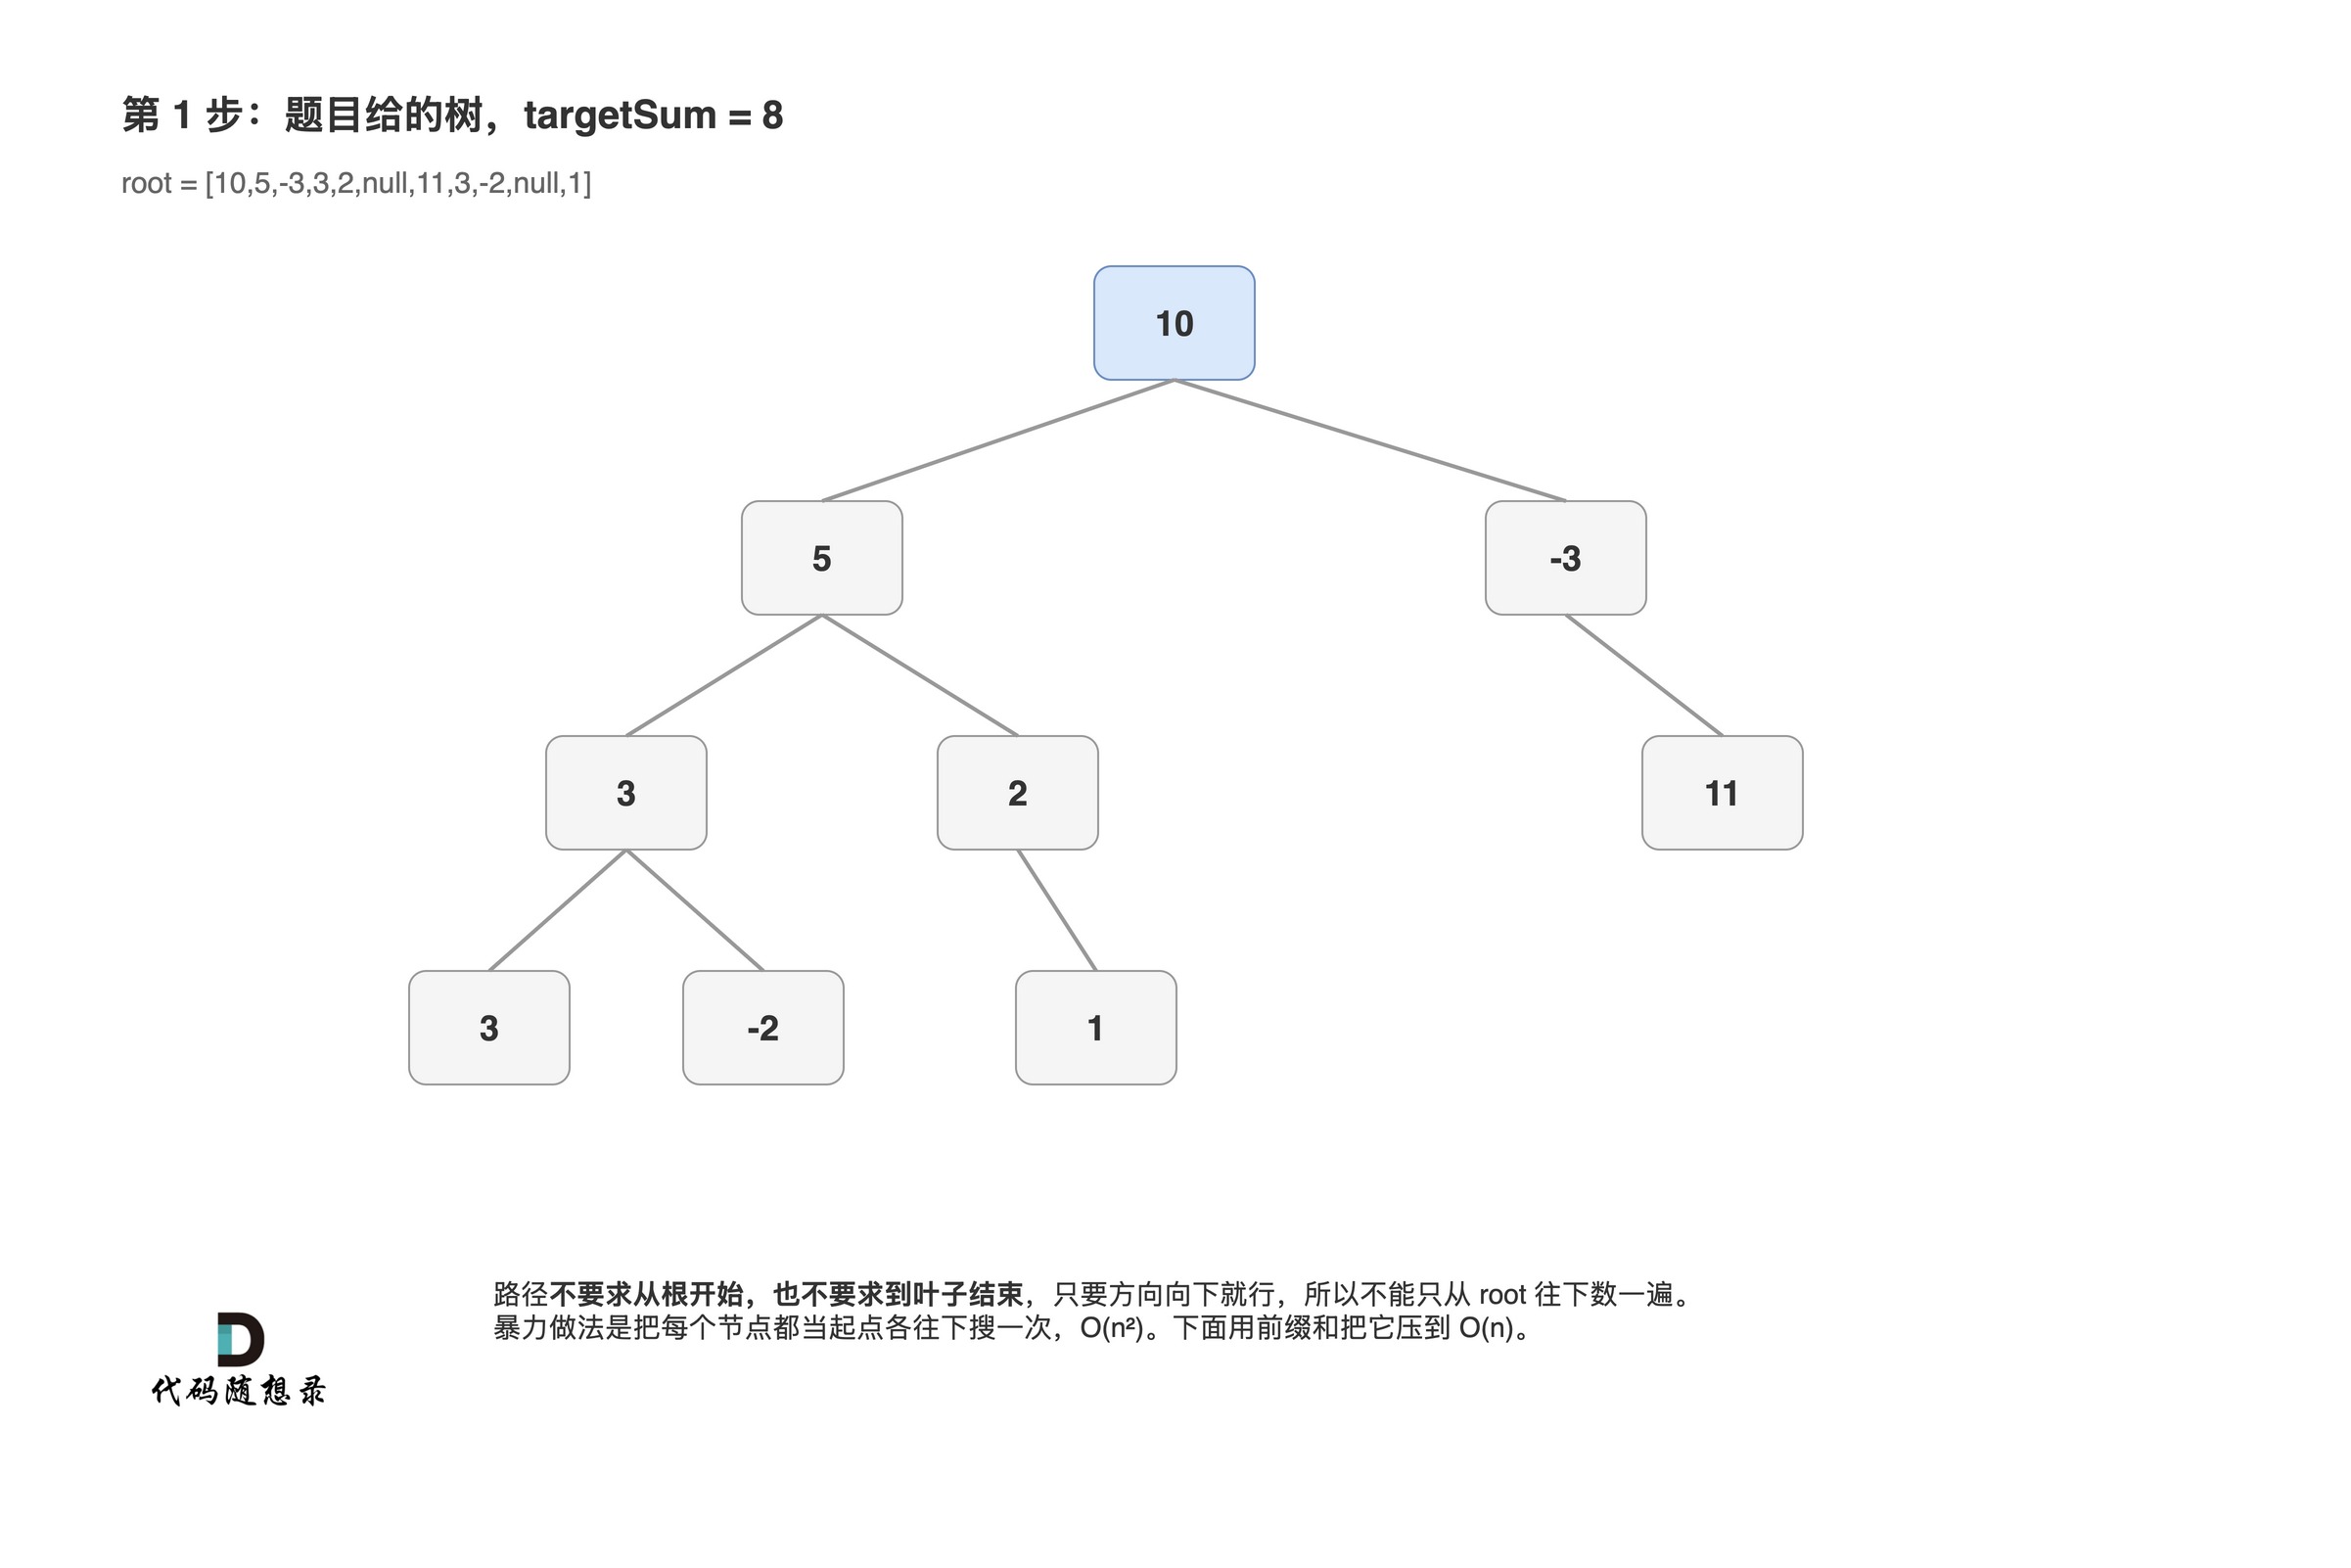
DFS 遍历过程,维护哈希表记录前缀和:
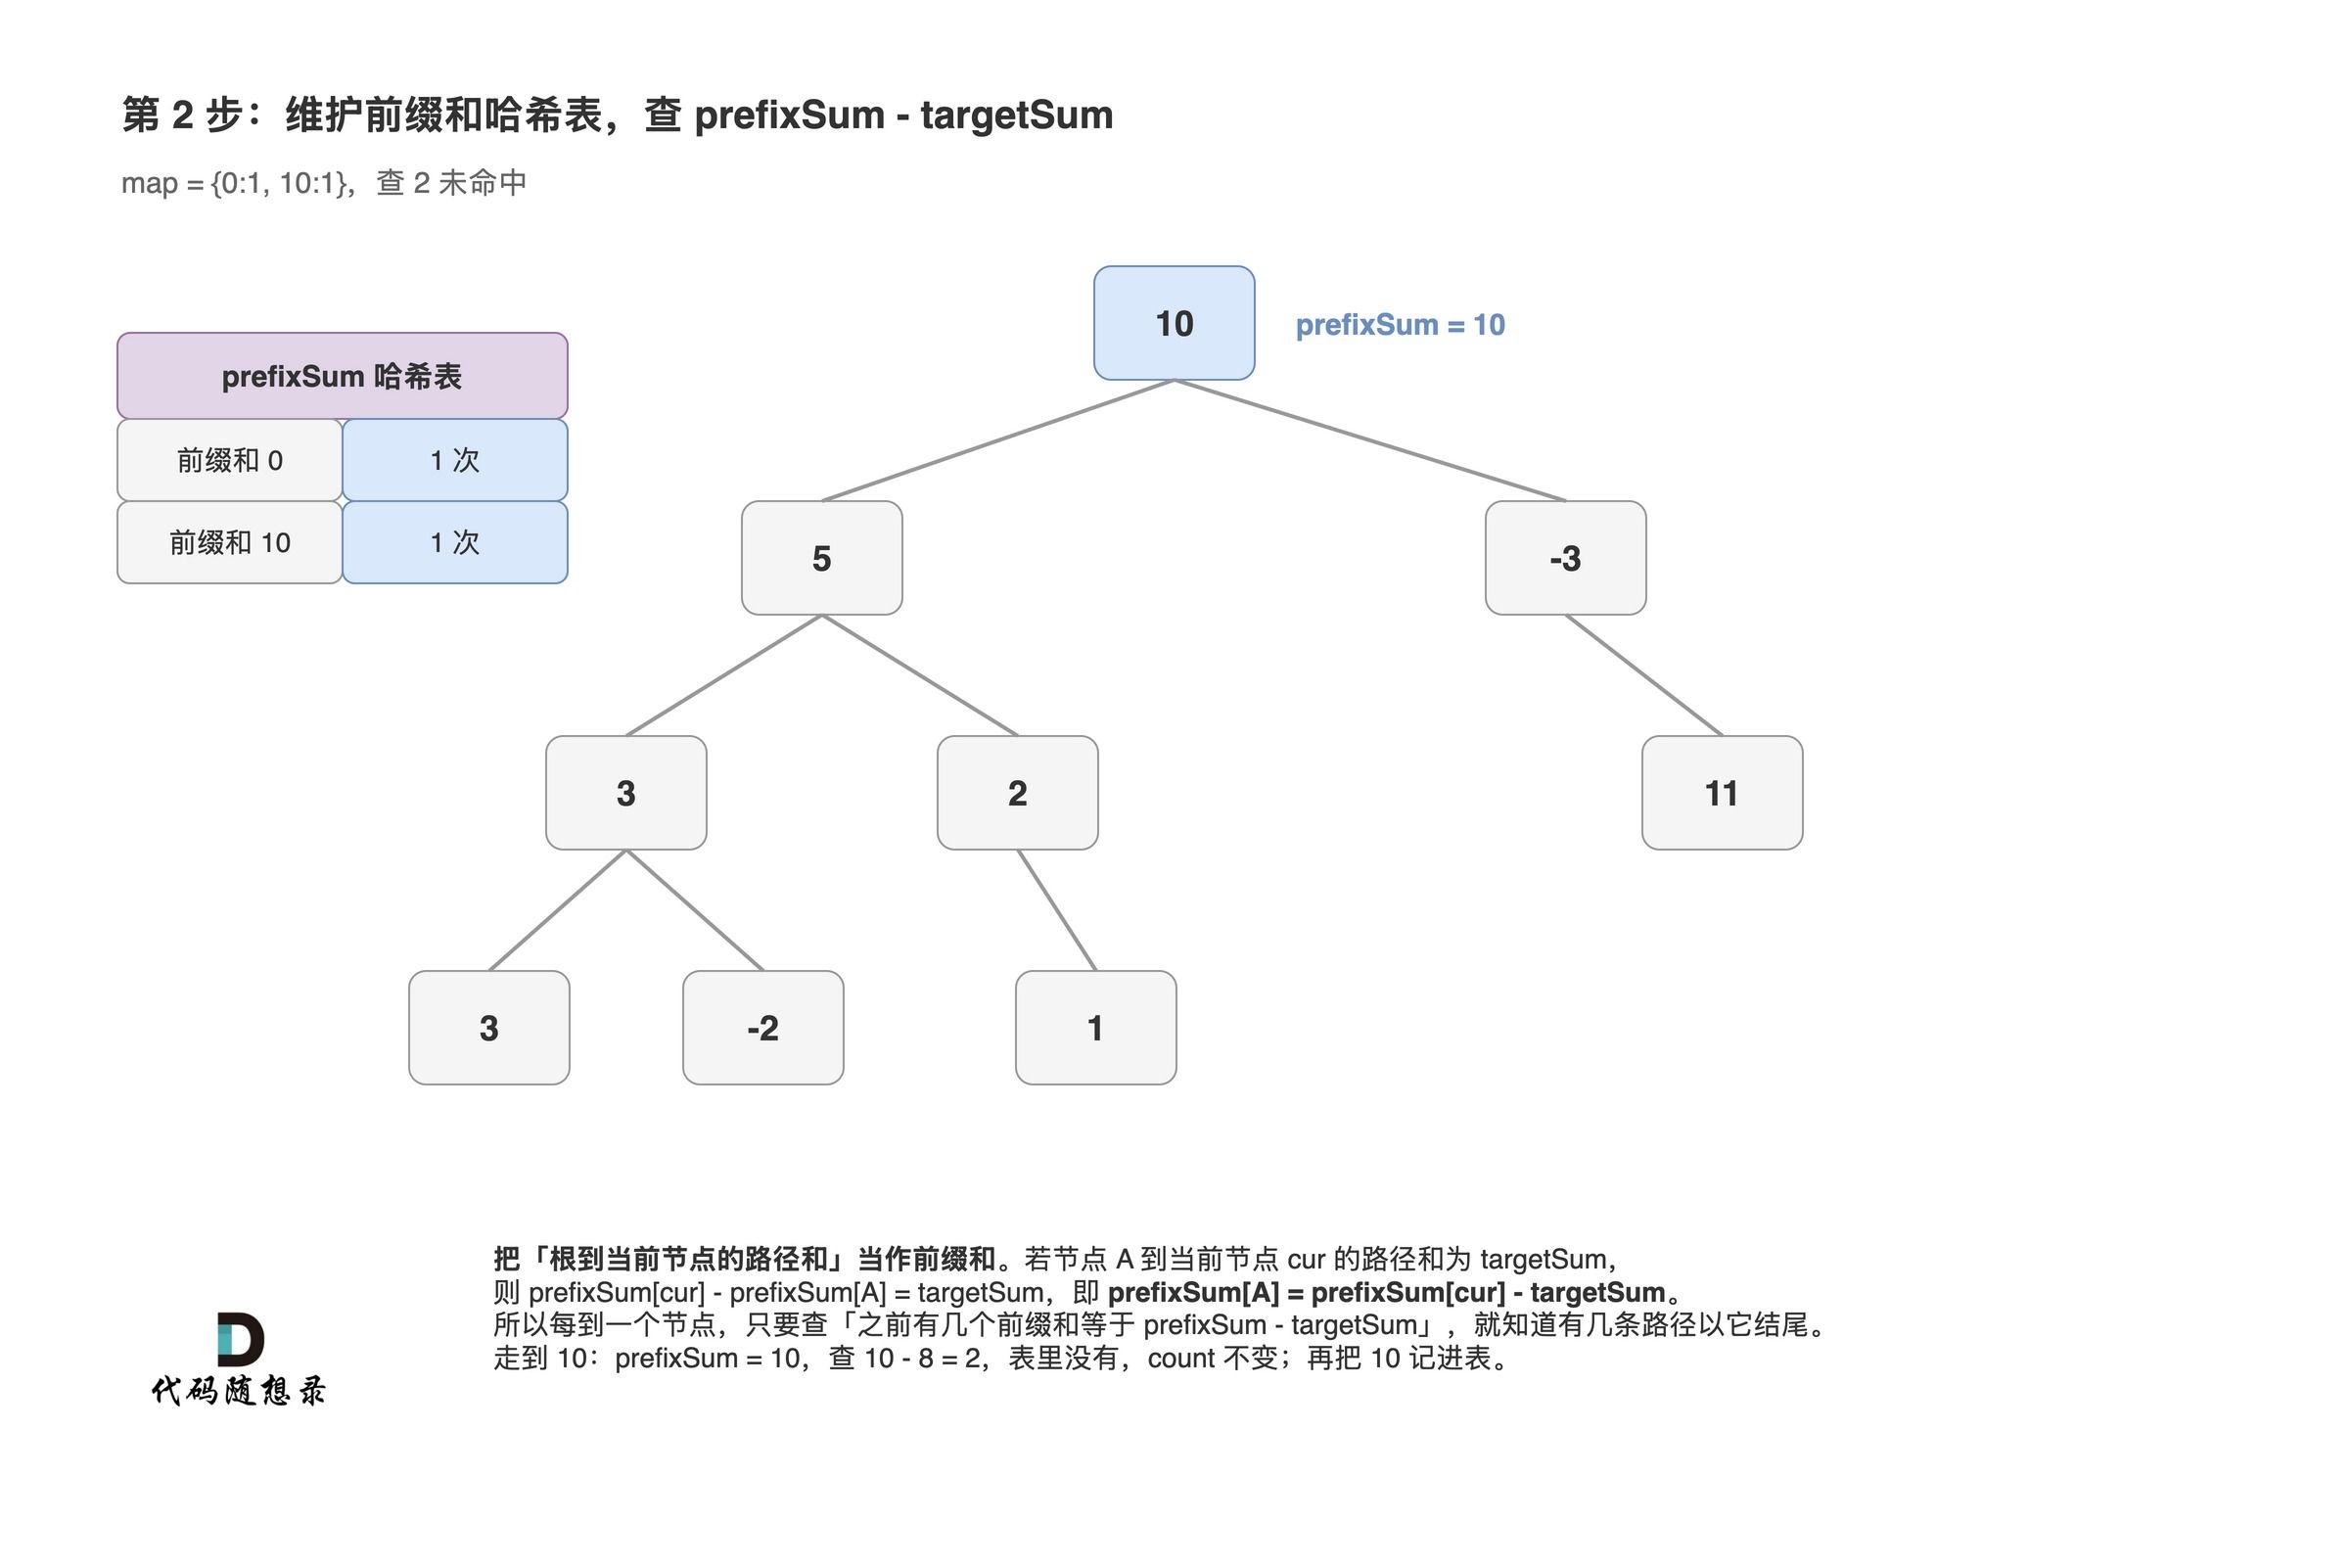
初始:map = {0: 1}(前缀和为 0 出现 1 次,表示空路径)
遍历节点 10:
- prefixSum = 10
- 查找 10 - 8 = 2,map 中没有
- 将 10 加入 map:{0: 1, 10: 1}
遍历节点 5:
- prefixSum = 15
- 查找 15 - 8 = 7,map 中没有
- 将 15 加入 map:{0: 1, 10: 1, 15: 1}
遍历节点 3:
- prefixSum = 18
- 查找 18 - 8 = 10,map 中有 1 个,count += 1
- 将 18 加入 map
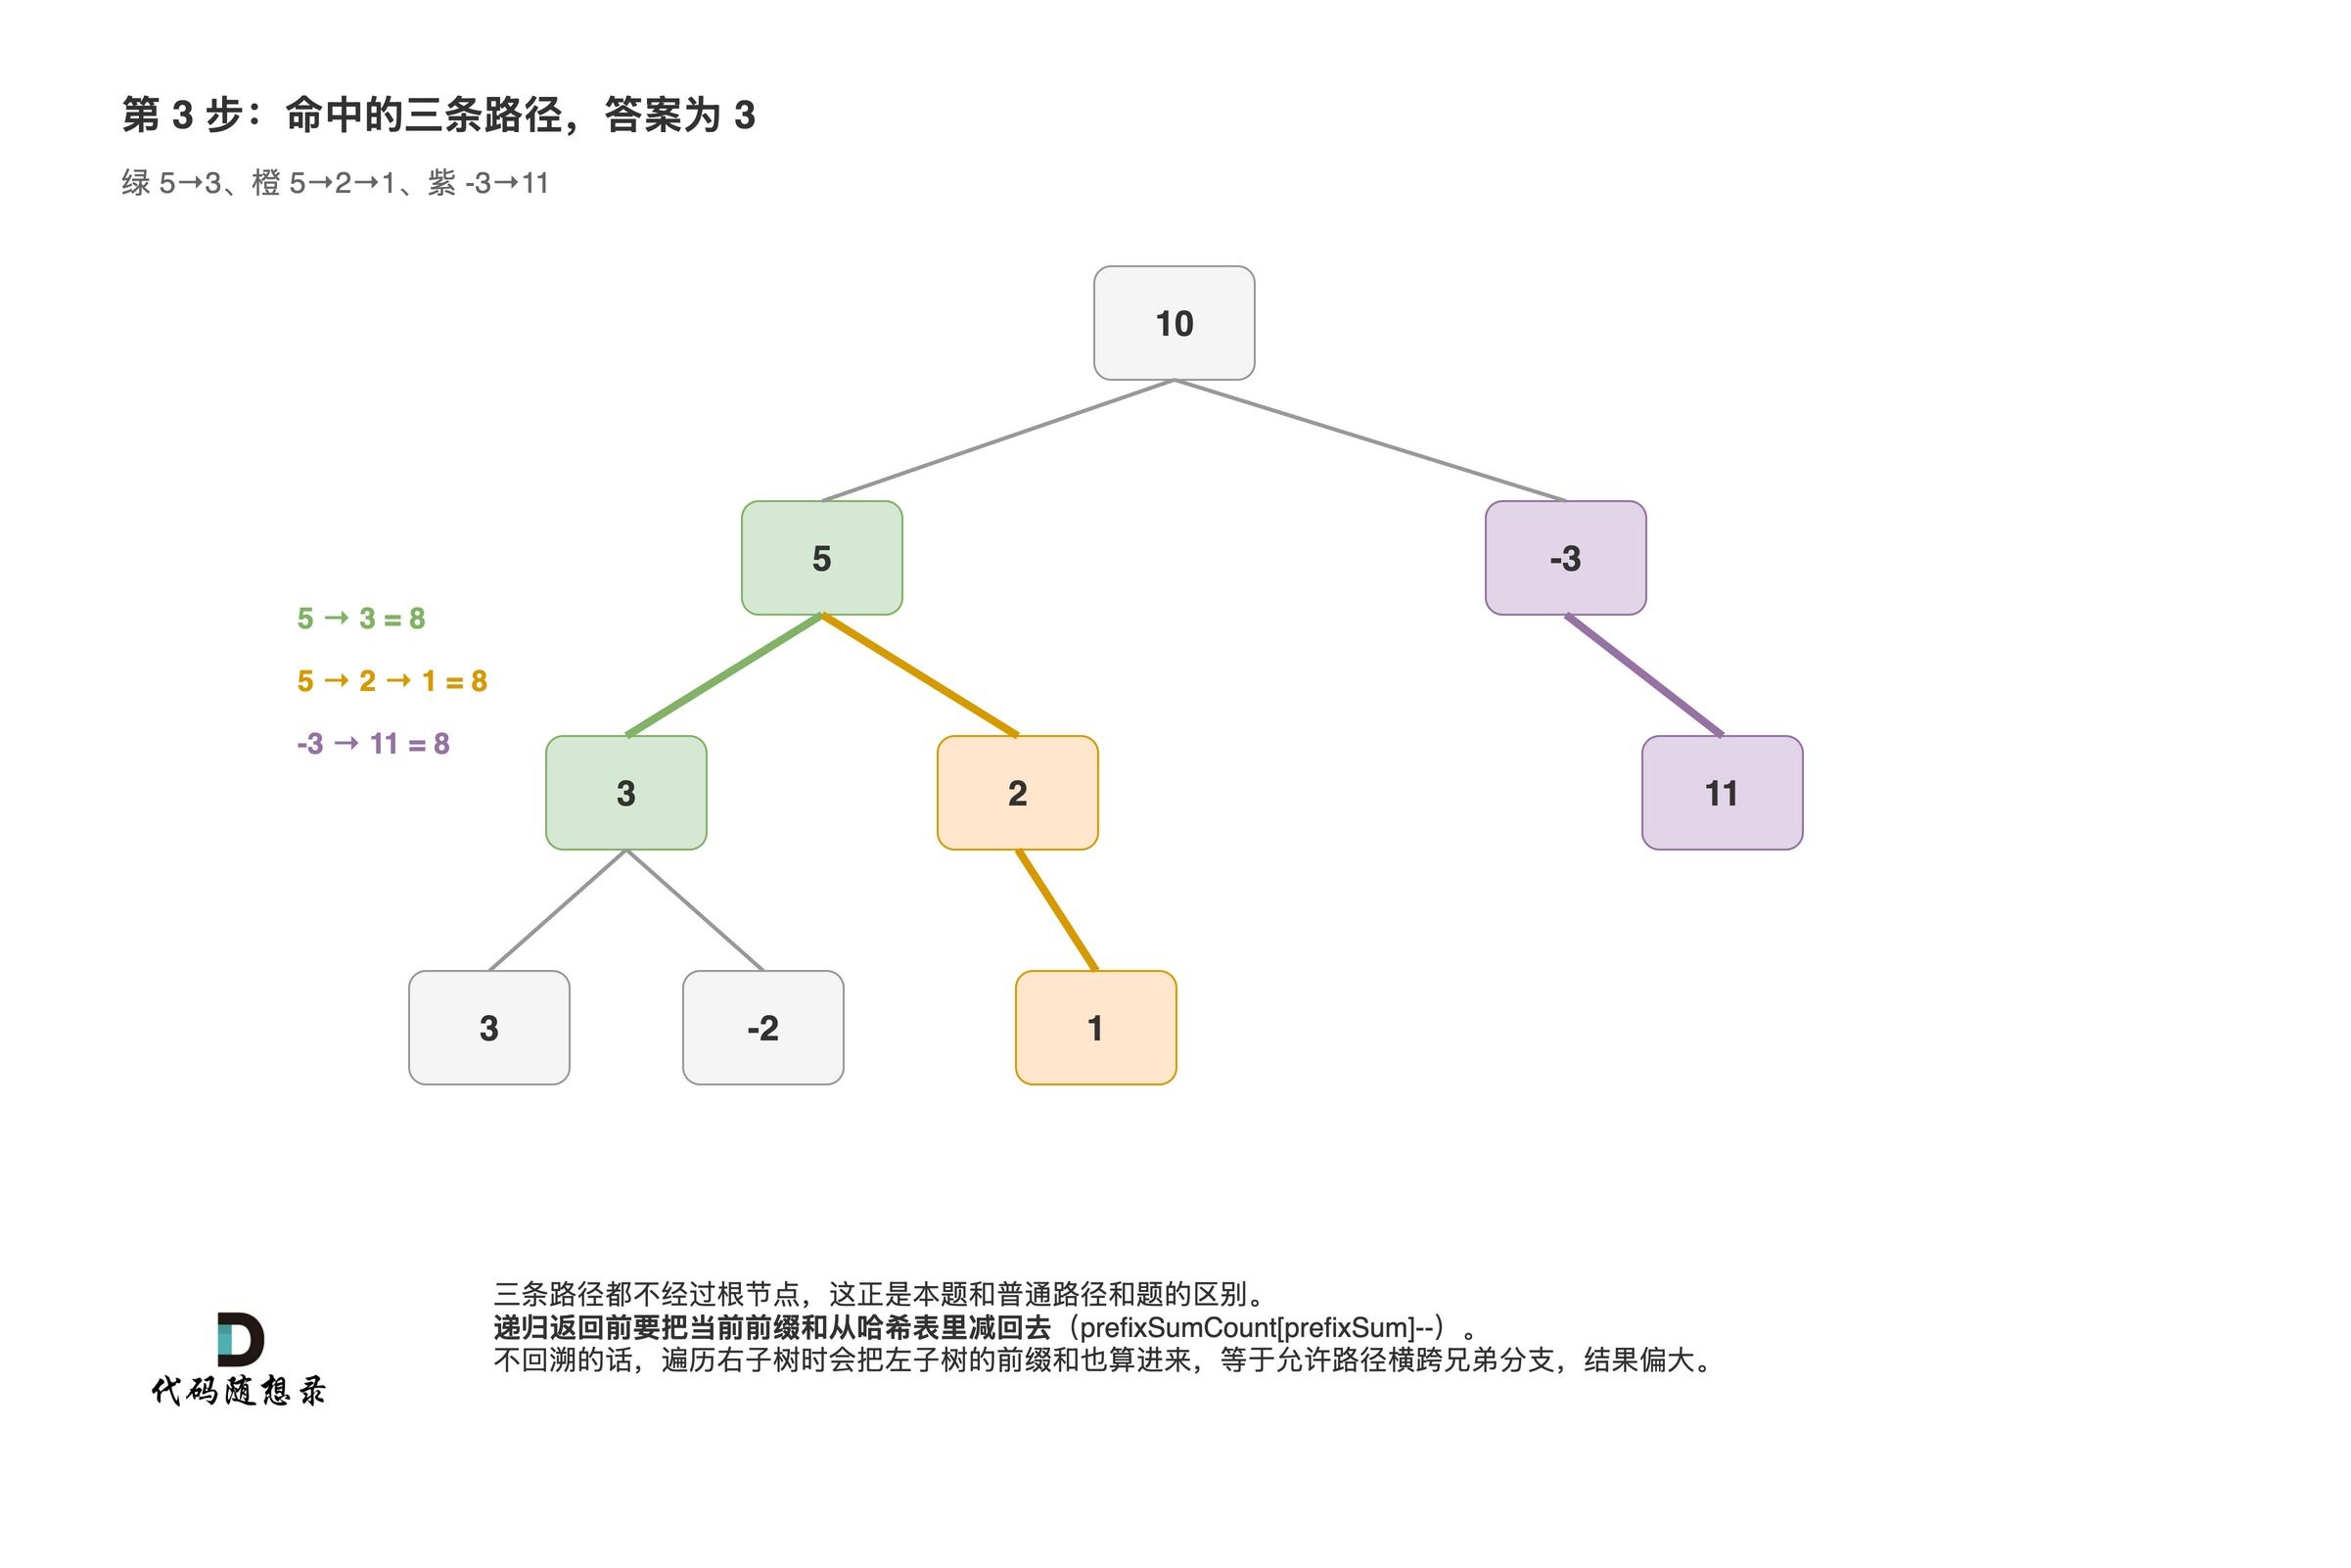
继续遍历,找到三条路径:
- 5 → 3(prefixSum[3] = 18,prefixSum[10] = 10,18 - 10 = 8)
- 5 → 2 → 1(prefixSum[1] = 18,prefixSum[10] = 10,18 - 10 = 8)
- -3 → 11(prefixSum[11] = 18,prefixSum[-3] = 10,18 - 10 = 8)
# 解题代码
class Solution {
public:
    int pathSum(TreeNode* root, int targetSum) {
        unordered_map<long long, int> prefixSumCount;
        prefixSumCount[0] = 1; // 前缀和为0的路径有1条(空路径)
        return dfs(root, 0, targetSum, prefixSumCount);
    }

private:
    int dfs(TreeNode* root, long long prefixSum, int targetSum, unordered_map<long long, int>& prefixSumCount) {
        if (root == nullptr) return 0;

        // 更新当前前缀和
        prefixSum += root->val;

        // 查找有多少个前缀和等于 (prefixSum - targetSum)
        int count = prefixSumCount[prefixSum - targetSum];

        // 将当前前缀和加入哈希表
        prefixSumCount[prefixSum]++;

        // 递归左右子树
        count += dfs(root->left, prefixSum, targetSum, prefixSumCount);
        count += dfs(root->right, prefixSum, targetSum, prefixSumCount);

        // 回溯:移除当前节点的前缀和(不能影响其他分支)
        prefixSumCount[prefixSum]--;

        return count;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
# 复杂度分析
- 时间复杂度:O(n),每个节点访问一次
- 空间复杂度:O(n),哈希表和递归栈的空间
# 其他语言
# Python3
class Solution:
    def pathSum(self, root: Optional[TreeNode], targetSum: int) -> int:
        prefix_sum_count = {0: 1}

        def dfs(node, prefix_sum):
            if not node:
                return 0

            # 更新前缀和
            prefix_sum += node.val

            # 查找匹配的前缀和
            count = prefix_sum_count.get(prefix_sum - targetSum, 0)

            # 加入当前前缀和
            prefix_sum_count[prefix_sum] = prefix_sum_count.get(prefix_sum, 0) + 1

            # 递归
            count += dfs(node.left, prefix_sum)
            count += dfs(node.right, prefix_sum)

            # 回溯
            prefix_sum_count[prefix_sum] -= 1

            return count

        return dfs(root, 0)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# Java
class Solution {
    public int pathSum(TreeNode root, int targetSum) {
        Map<Long, Integer> prefixSumCount = new HashMap<>();
        prefixSumCount.put(0L, 1);
        return dfs(root, 0L, targetSum, prefixSumCount);
    }

    private int dfs(TreeNode root, long prefixSum, int targetSum, Map<Long, Integer> prefixSumCount) {
        if (root == null) return 0;

        prefixSum += root.val;
        int count = prefixSumCount.getOrDefault(prefixSum - targetSum, 0);

        prefixSumCount.put(prefixSum, prefixSumCount.getOrDefault(prefixSum, 0) + 1);

        count += dfs(root.left, prefixSum, targetSum, prefixSumCount);
        count += dfs(root.right, prefixSum, targetSum, prefixSumCount);

        prefixSumCount.put(prefixSum, prefixSumCount.get(prefixSum) - 1);

        return count;
    }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# Go
func pathSum(root *TreeNode, targetSum int) int {
    prefixSumCount := map[int]int{0: 1}
    return dfs(root, 0, targetSum, prefixSumCount)
}

func dfs(root *TreeNode, prefixSum, targetSum int, prefixSumCount map[int]int) int {
    if root == nil {
        return 0
    }

    prefixSum += root.Val
    count := prefixSumCount[prefixSum-targetSum]

    prefixSumCount[prefixSum]++

    count += dfs(root.Left, prefixSum, targetSum, prefixSumCount)
    count += dfs(root.Right, prefixSum, targetSum, prefixSumCount)

    prefixSumCount[prefixSum]--

    return count
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# JS
var pathSum = function(root, targetSum) {
    const prefixSumCount = new Map();
    prefixSumCount.set(0, 1);

    const dfs = (node, prefixSum) => {
        if (!node) return 0;

        prefixSum += node.val;
        let count = prefixSumCount.get(prefixSum - targetSum) || 0;

        prefixSumCount.set(prefixSum, (prefixSumCount.get(prefixSum) || 0) + 1);

        count += dfs(node.left, prefixSum);
        count += dfs(node.right, prefixSum);

        prefixSumCount.set(prefixSum, prefixSumCount.get(prefixSum) - 1);

        return count;
    };

    return dfs(root, 0);
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# 与代码随想录联系
这道题综合了两个重要知识点:
- 前缀和 + 哈希表 — 在 560.和为 K 的子数组 中详细讲过这个技巧
- 二叉树DFS遍历和回溯 — 在代码随想录 二叉树章节 和 回溯章节 有系统讲解
很多录友第一次做这道题,会卡在"为什么要回溯"这里。
想清楚树的结构:左子树和右子树是两条独立的路径,不能共享前缀。所以遍历完左子树后,要把左子树的前缀和移除,不然会影响右子树的判断。
这种"做选择 → 递归 → 撤销选择"的模式,就是回溯的经典应用。
建议录友们先把数组的前缀和问题理解透彻,再来做树上的前缀和会更容易理解。
评论
验证登录状态...